 开云体育
你有莫得想过,一份写着"如何用号召行器具处理文档"的操作手册,离一个实在能考验AI智商的复杂任务,到底有多远?
这个问题看起来很小,但它恰正是面前AI闇练领域最头疼的事情之一。
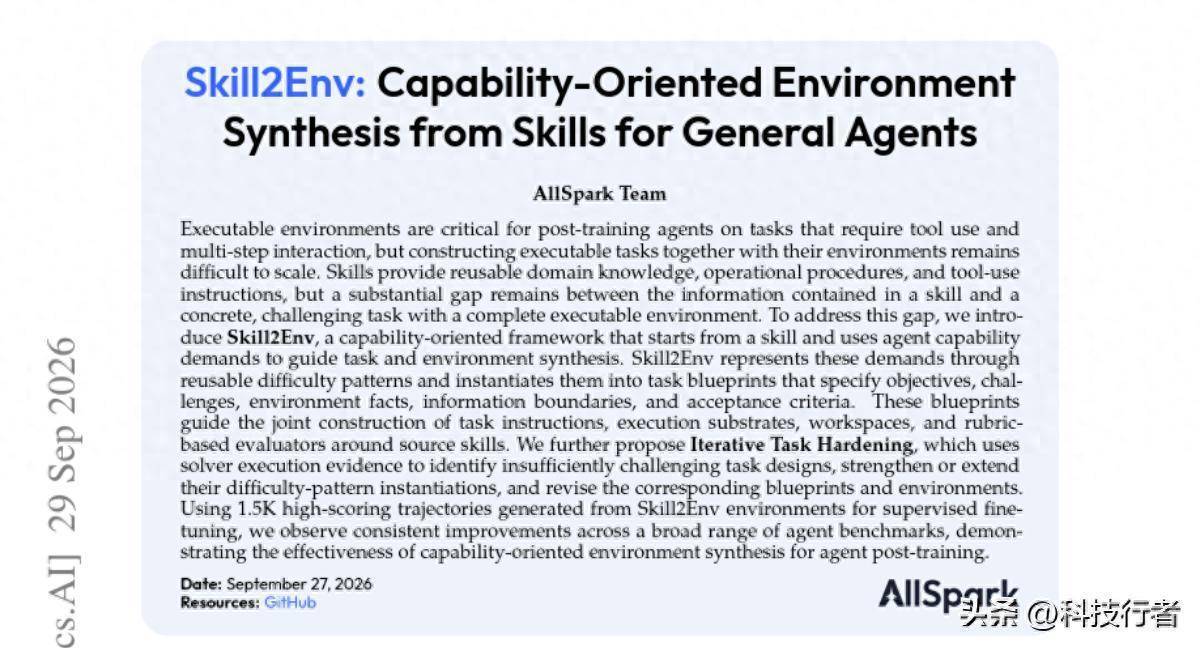
先说论断:差得很远。而这篇来自AllSpark团队的论文,讲的即是若何把这段距离补上。
**当AI智能体的闇练遇上了"环境荒"**
先说说布景。面前的大说话模子越来越多地被用来干活,不是浅易聊天,而是要用器具、多法子操作、完成复杂任务。
要闇练这么的智能体,光靠喂笔墨数据是不够的,你得让它在一个实在可扩充的环境里摸爬滚打,就像教一个新职工,光看操作手册没用,得让他真实坐到电脑前,处理一堆乱七八糟的文献、建造一个实在的bug、应付一个突发的系统报错。
问题是,搭建这么的"闇练场"极其汉典。
一个可扩充的任务环境,不仅仅写一句任务阐述那么浅易。你得设置好器具,让AI能调用;你得准备一个使命空间,装着任务需要的多样文献和运转情状;你还得想象一套评分圭臬,能准确判断AI作念得对分歧。这几件事丝丝入扣,任何一个要道没搭好,通盘环境即是废的。
要是靠东谈主工一个任务一个任务地手搭,那产能天花板肉眼可见。业内因此开端探索自动化合成这些环境的模范,而"工夫"(skill,一种打包好的领域常识和操作经过,内部可能还带着剧本、模板等提拔府上)成了一个自然的切入点。
工夫*:一种可复用的常识包,内部包含某类任务的操作经过、领域常识,偶然还附带剧本、模板、参考府上,便捷径直用于扩充具体任务。
但工夫包和实在的任务之间,隔着一条鸿沟。一个工夫可能仅仅说"这么用号召行处理PDF文档",可它没告诉你,什么样的任务才算实在考验AI,任务里该埋藏什么样的罗网和挑战,评分圭臬又该若何定。之前的一些使命,比如SkillSynth用工夫图谱采样生成结尾任务,Terminal-World让工夫同期驱动任务领导和环境的构建,FACET靠跨工夫场景重建来保证一致性,都在往这个场地尽力,但它们大多是从"若何把工夫变成任务"这个角度切入的。
Skill2Env团队换了个发问形势:与其问"工夫能变成什么任务",不如先问"AI智能体到底需要在哪些智商上被考验",然后倒推且归想象任务。这个视角上的改换,才是这篇论文实在的启航点。
**难点不在生成任务,而在生成"刚刚好难"的任务**
这里有个容易被忽略的罗网:生成任务不难,生成一个有挑战性、能实在泄露AI智商短板的任务,才难。
打个譬如,你要给学生出一套模拟考卷。粗率找几谈题强迫,很容易;但要是你想通过这套卷子准确筛出哪些学生的期骗题薄弱、哪些审题智商有问题,你就得先想明晰"期骗题智商"到底包含哪些子智商,再针对性地想象题目结构,让每一谈题都精确地踩在某个智商点上。
要是不这么想象,会若何?
你可能会出一堆题面很复杂但其实都能靠蒙对谜底的题,或者一堆看起来吓东谈主但AI粗率试试就能蒙混过关的任务。数据上,论文背面会告诉你,这种"看起来难但其实不难"的任务无数存在,一开端生成的500个任务里,尽然有48.4%的完成度是满分,这阐述这批任务对那时的模子来说毫无难度可言。
Skill2Env的解法,是先梳理出智能体在完成复杂任务时实在需要的五种中枢智商:环境清爽、绸缪智商、工夫使用、长程一致性、乌有还原。
环境清爽*:能从环境提供的信息里找出和任务关连的事实,清爽方针和不停条件。
绸缪智商*:能识别操作之间的依赖关系,并根据环境变化连续调养扩充运筹帷幄。
工夫使用*:能清爽工夫包里的器具使用阐述和操作经过,并根据面前任务需求正确期骗。
长程一致性*:在多法子扩充过程中握续跟踪情状变化,保证中间驱散和环境情状一致。
乌有还原*:能根据扩充反应定位问题、调养操作、连续激动任务。
这五种智商不是诬捏拍脑袋想出来的,而是从"完成一个复杂任务"这件事本人拆解出来的过程要道:清爽、绸缪、扩充、调养,周而复始。
**难度步地:把轮廓智商翻译成具体的"埋雷"形势**
光知谈要考验哪种智商还不够,你还得知谈若何把这种智商实在"变成"任务里的具体阻遏。这即是Skill2Env里"难度步地"(difficulty pattern)这个主张要科罚的问题。
难度步地*:一种可复用的任务挑战构造形势,形容了若何把某种智商需求滚动为具体的任务想象。比如"信息分散"这个步地,即是把完成任务所需的重要事实拆散到多个不同的信息源里,逼着AI必须主动征集强迫,材干凑皆完好意思谜底。
论文里给出了一个相配天真实例子来阐述为什么需要这种紧密想象:雷同是考"环境清爽"智商,"信息分散"步地要求AI把洒落在不同来源的事实拼起来;而"隐性不停"步地则要求AI从莫得明说的国法中估计出放置条件。这是完全不同的两种难法,一个考的是信息整合智商,另一个考的是推明智商。
这就好比雷同是"考验体能"这一个大类,跑步和举重根柢不是一趟事,你不成用归拢套闇练运筹帷幄应付两种不同的智商短板。
研讨团队一开端准备了100种这么的难度步地,漫步在五个智商维度下,一共整理出这五大类共100种具体的构造形势(附录里详备列了每一种,比如"泰斗分解"要求你在相互矛盾的信息源里,根据明确的泰斗等第判断该信任谁;"情状依赖"要求后续操作必须依赖前边法子产生的驱散,酿成一条不成打乱的依赖链)。
给定一个具体的工夫,系统会挑出和这个工夫适配的一组难度步地,组合到一齐,酿成一个有明确挑战想象的任务。不同的步地组合,不错让归拢个工夫撑握起难度和覆按要点完全不同的任务。这就好比归拢套食材,不同的搭配形势能作念出考验刀工的菜、考验火候的菜、考验调味的菜。
**蓝图:一份开通想法和收尾的"施工公约"**
有了难度步地还不够,你得把这些轮廓的"我想考验什么"落地成具体的"任务文献长什么样、评分圭臬是什么"。Skill2Env在这一步引入了任务蓝图(task blueprint)的主张。
任务蓝图*:一份作家视角的"公约文档",把任务方针、挑战想象、撑握事实、验收圭臬、信息界限这些身分明确写明晰,用来引导后续任务领导、器具设置、使命空间、评分器的构建。
这个"公约"的敬爱在于,环境合成不是一次性的解放阐扬,而是班班可考、可追想、可复现的工程经过。它明确章程了三件容易被冷漠的事情:
第一,扩充需求,也即是完成任务需要哪些器具智商、运行时依赖、运转资源和情状。
第二,信息界限,分歧明晰哪些信息任务阐述里径直给出,哪些需要AI我方在使命空间里翻找发现,哪些需要AI靠推理材干得出。这少量相配重要,因为一个任务要是把通盘信息都摆在明面上,那就莫得难度可言了;但要是连解题所需的重要思绪都藏起来,那即是坏心刁难,而不是合理的挑战。
第三,验收圭臬,最终用来打分的具体条件。
有了蓝图之后,一个评分器会把这些验收圭臬翻译成一套评分细目(rubric),每条细目给一个权重,权重加起来是1,部分能用模范自动判分的走模范判分,剩下判断相对浑沌的部分交给大说话模子来打分,并允许给部分分。最终的任务奖励是通盘细宗旨加权对等分。
打个譬如,这就像试验出卷时,有的题目是给与题,机器径直扫描判分,快而准;有的题目是简答题,必须靠有训戒的敦厚读懂考生的表述、给出有理有据的部分分。要是你把简答题也硬套成给与题的判分形势,要么会漏掉实在作念对了但表述形势不一样的学生,要么会给毫无逻辑但蒙对重要词的谜底打高分。是以两种判分形势并存,材干兼顾服从和准确性。
**迭代任务加固:让AI我方的发达,成为逼出更难任务的字据**
这里是我合计整篇论文最挑升想的一个想象:迭代任务加固(Iterative Task Hardening)。
着手生成的任务,即使经过悉心想象,也可能仍然对面前的AI来说太容易了。前边提到过阿谁48.4%满分率的数据,这阐述初版任务照实存在这个问题。
Skill2Env的作念法是,让一个求解者智能体(solver)先去跑一遍这些任务,然后系统去看它的扩充印迹:哪些想象好的挑战被绕过了,哪些要道AI处理得中途披缁,哪些地方还存在实在的穷苦。但凡得分向上某个阈值(论文里设的是0.7)的任务,就被判定为"太浅易了,需要加固"。
这个会诊过程不是浅易地看最终得分,而是实在去比对扩充轨迹和当初想象的挑战点。举个论文里具体的例子会更明晰。
在一个财务对账任务里,着手版块要求AI查对一家议论公司季度账单里的三处问题:一处是费率超标,一处是出租车报销逾额,一处是天数上限超支。第一次跑完,AI拿了满分,而且扩充日记炫夸它致使写了一段Python自检剧蓝本考据我方算的数字对分歧。
会诊系统看完这些字据,判定这个任务对面前的求解者来说仍是"不够看了",于是提议了一系列加固决策:把重要费率信息藏进一份需要署名阐明的公约附件里,而不是放在容易读取的网页导出文献中;把一笔差旅费拆成跨两个月重迭报销,逼着AI必须作念跨发票的比对,而不是逐张查对;再加一个归拢供应商的孤立姿首,让AI必须我方判断哪些账单在本次对账范围内;把一处金额有益印刷成1435而不是准确的1425,逼着AI分歧原始账单金额和改造后金额的各异;把某张发票改成部分付款,让"已开票金额"和"施行已付现款"变成两个必须分开处理的主张。
这些加固工夫有一个共同点:它们竣工针对AI上一轮"粗豪过关"的地方精确打击,不是粗率加难度,而是有的放矢地补上过错。
这就好比一个教会发现某个通顺员的瑕玷仍是被针对性闇练弥补了,要是这时刻还连续练雷同的姿首,通顺员只会越来越粗豪,教会必须换一套新动作,专门盯着通顺员刚刚展现出的刚烈驾驭阿谁还没被磨真金不怕火到的部位用劲。
第二轮加固更挑升想。研讨团队查验扩充记载时发现,有一次跑批出现了四次文档鬈曲失败,原因是号召行参数被乌有地拆成了两段,导致OCR器具径直报错中止。AI自然靠切换到另一个图像读取器具"绕往时了",最终任务照样拿了分,但这暴披露一个隐患:AI的文档处理经过其实很脆弱,此次仅仅气运好,还有备用旅途不错走。
针对这个发现,团队把重要字据藏进了一份莫得笔墨层、必须靠OCR材干读出内容的扫描版PDF里,径直让这条"脆弱的路"变成"无法绕过的路"。这是从一次不测的扩充失败里,反过来挖出了一个新的、有价值的测试点。
这种"用扩充字据反哺想象"的想路,施行上是把AI我方的答题记载变成出题敦厚的教学参考。传统出题通常靠敦厚的训戒判断这谈题够不够难,而这里是径直让"学生"先作念一遍,根据学生的施行发达动态调养题目难度,这比单纯靠东谈主工训戒判断要精确得多。
论文用了一组对照实验考据加固照实有用:从500个经过两轮加固的配对任务来看,满分率从着手的48.40%,一齐降到24.80%,再降到15.40%,而平均交互轮次从25.91轮,上涨到36.54轮,再到38.85轮。换句话说,加固两轮后,任务的满分难度裁汰了33个百分点,AI要多花大致50%的交互法子材干勉强应付。
**工夫库的限度和筛选:从4.7万个候选到3000多个可用**
再说说这些工夫是从那儿来的。研讨团队从一个叫ClawHub的公开工夫库里下载了向上4.7万个工夫文献夹,然后用三条圭臬筛选:实用性(这个工夫是不是真实有明确用途)、运行兼容性(硬件、系统、权限要求是不是和方针Linux沙箱环境兼容)、部署可行性(运行所需的输入、依赖、数据、管事是不是能被合理地准备出来)。
层层过滤下来,最终留住3000多个工夫文献夹用于后续的环境合成。这个筛选比例本人就阐述了一件事:公开资源里实在能变成高质料闇练环境的比例其实不高,大部分要么太琐碎,要么运行条件太尖刻,要么根柢没法在圭臬化沙箱里跑起来。
最终通盘活水线跑出来2963个可扩充当务。分析这些任务的组成会发现,它们触及的资源类型极为丰富:19649个工夫关连文献,涵盖13种编程说话或标志说话,其中Python和Shell最常见;有101种不同的外部模范被援用,从常见的git、curl到专科的ffmpeg都在其中;扩充环境里触及8个软件包生态系统,总共4242个不同的依赖包,加上823个不同的号召行器具称呼。
任务粉饰的领域也很广,一共25个不同的工夫领域,最大的一类是软件工程与代码质料,占了320个任务;其他还包括智能体挂念与自我升迁、金融阛阓、办公文档、科学计较、媒体处理等等。
**闇练后果:小模子加少量点数据,跨基准全面升迁**
搭好了环境,最终宗旨照旧要看它能不成真实帮AI变强。
研讨团队的作念法是,用一个教师模子(DeepSeek-V4-Flash)在这些合成任务上跑出扩充轨迹,筛选出得分向上0.9的高质料轨迹,一共只留了1500条,拿这些数据去微调一个限度不算大的模子Qwen3.6-35B-A3B(350亿参数,激活参数独一30亿)。
驱散是,微调之后的模子在七个不同的智能体基准测试上全部有升迁,对等分从36.6升迁到45.0,涨了8.4个百分点。
具体来看,SkillsBench(一个专门测试工夫使用智商的基准)升迁了14.3个百分点,Terminal-Bench 2.1(结尾任务扩充基准)升迁了13.5个百分点,SWE-bench Multilingual(多说话代码建造基准)升迁了7.7个百分点,AutomationBench升迁了7.34个百分点,VitaBench升迁了5.87个百分点,Claw-Eval升迁了5.51个百分点,τ?-Banking升迁了4.47个百分点。
这里有一个相配值得琢磨的对比:微调后的这个350亿参数小模子,在七个基准里的六个上,向上了参数限度比它大得多的Qwen3.5-397B-A17B(激活参数170亿)。
这阐述什么?
升迁的来源不是模子本人变大了,而是闇练数据里蕴含的智商信号实在被模子学到了,而且这种智商信号粗略迁徙到闇练时完全没见过的任务类型和领域上去。
这就好比两个学生,一个上了海量的补习班但每节课都学得零碎,另一个只上了精挑细选的几节课,但每节课都精确打在他的智商短板上,驱散后者的试验收获反而更好。这不是因为他更"灵巧",而是因为他汲取的每一份闇练都有的放矢。
再看一个细分实验,专门分析SkillsBench上升迁的具体来源。研讨团队分歧了"允许AI自动加载工夫"和"关闭自动加载但工夫文献仍可拜谒"两种情况,发现开启工夫加载时升迁了14.3个百分点,关闭时也升迁了10.4个百分点。跨八个领域来看,七个领域都有正向升迁,独一金融领域基本握平(在工夫开启的情况下)。升迁最大的三个领域分别是媒体内容(升迁46.7个百分点)、数学与运筹学(升迁26.9个百分点)、软件工程(升迁23.4个百分点)。
研讨团队还作念了跨不同扩充框架(harness)的考据,在pi、Terminus-2、OpenCode、Claude Code这四种不同的扩充框架下都作念了测试,驱散全部升迁:pi框架升迁11.2个百分点,Terminus-2升迁13.5个百分点,OpenCode升迁16.9个百分点,Claude Code升迁12.3个百分点。这种跨框架的一致升迁阐述,学到的智商不是针对某种特定接口的死记硬背,而是相对通用的行径步地翻新。
论文里还作念了一个很塌实的消融实验,专门看"迭代加固"这个要道到底值不值。他们限度闇练数据量和质料门槛完全一致(都是500条兴盛r>0.9的轨迹),只改变任务是履历了0轮、1轮照旧2轮加固,驱散七基准对等分分别是40.58、42.51、42.87。也即是说,在雷同的数据预算下,用更难的任务生成闇练数据,后果照实更好,从第0轮到第2轮升迁了2.29个百分点。
**回到阿谁着手的问题**
说回开头阿谁问题:从一份工夫文档到一个实在能考验AI的任务,中间到底隔着什么?
读完这篇论文,我合计谜底不是"信息量不够",而是"视角分歧"。工夫文档告诉你若何用器具,但不会告诉你什么样的使用场景才叫实在的挑战。Skill2Env的孝敬在于,它把"咱们想考验AI的什么智商"手脚想象任务的启航点,而不是"这个工夫能拼出什么故事"。这个国法上的调转,看似仅仅想路上的一个转弯,但决定了通盘任务生成活水线的走向。
Q&A
Q1:Skill2Env是什么?
A:Skill2Env是AllSpark团队提议的一套智商导向的框架,能从工夫包启航,鸠合智能体的智商需求自动生成可扩充的任务和闇练环境,最终身成了2963个可扩充当务。
Q2:迭代任务加固具体是若何运作的?
A:让求解智能体先跑一遍任务,系统根据扩充字据判断哪些想象好的挑战被粗豪绕过了,然后针对性地强化或新增难度步地,再重腾达成任务,如斯轮回,徐徐让任务变得更有挑战性。
Q3:用Skill2Env生成的数据闇练模子后果若何样?
A:只用1500条高质料轨迹微调一个350亿参数的小模子开云体育,在七个智能体基准上对等分从36.6升迁到45.0,且在六个基准上向上了参数目大得多的对比模子。